
학습 컨테이너 만들기
평소 만들던 학습 도커 이미지를 플랫폼 학습 마법사에서 돌리기 위한 계약과 절차
필요 권한: 개발DEVELOPER · OPERATOR · ADMIN
평소 만들던 학습 도커 이미지를 그대로 만들면 됩니다. 플랫폼이 주는 스크립트를 이미지에 넣을 필요도, 표준 출력에 특별한 형식을 지킬 필요도 없습니다. 데이터는 플랫폼이 미리 디렉터리에 놓아 주고, 설정은 환경 변수로 들어오며, 남길 것은 MLflow 로 올리고, 성공 여부는 종료 코드로 알리면 됩니다.
이 절은 그 바깥쪽 계약과 검증 절차를 다룹니다. 모델 알고리즘 자체는 다루지 않습니다.
한 장 요약
| 항목 | 내용 |
|---|---|
| 전달물 | docker save 로 만든 이미지 tar (+ 태그 이름 · sha256) |
| 실행 | 플랫폼은 이미지의 ENTRYPOINT 를 그대로 실행합니다. 커맨드를 덮어쓰지 않습니다 |
| 입력 | 학습 데이터는 플랫폼이 미리 내려받아 /geo/dataset 에 둡니다. 다운로드 코드도, 스토리지 자격 증명도 필요 없습니다 |
| 설정 | 하이퍼파라미터·태스크·GPU 는 모두 환경 변수로 들어옵니다 |
| 출력 | 남길 것은 모두 MLflow 로 올립니다. 컨테이너 파일 시스템은 실행이 끝나면 사라집니다 |
| 종료 | exit 0 = 성공, 그 외 = 실패. 이것이 전부입니다 |
학습 한 건의 흐름
학습 한 건은 Kubernetes Job 하나(파드 하나) 로 돕니다. ①③, ⑧⑩ 은 플랫폼이 하고, 컨테이너가 관여하는 것은 ④~⑦ 뿐입니다.
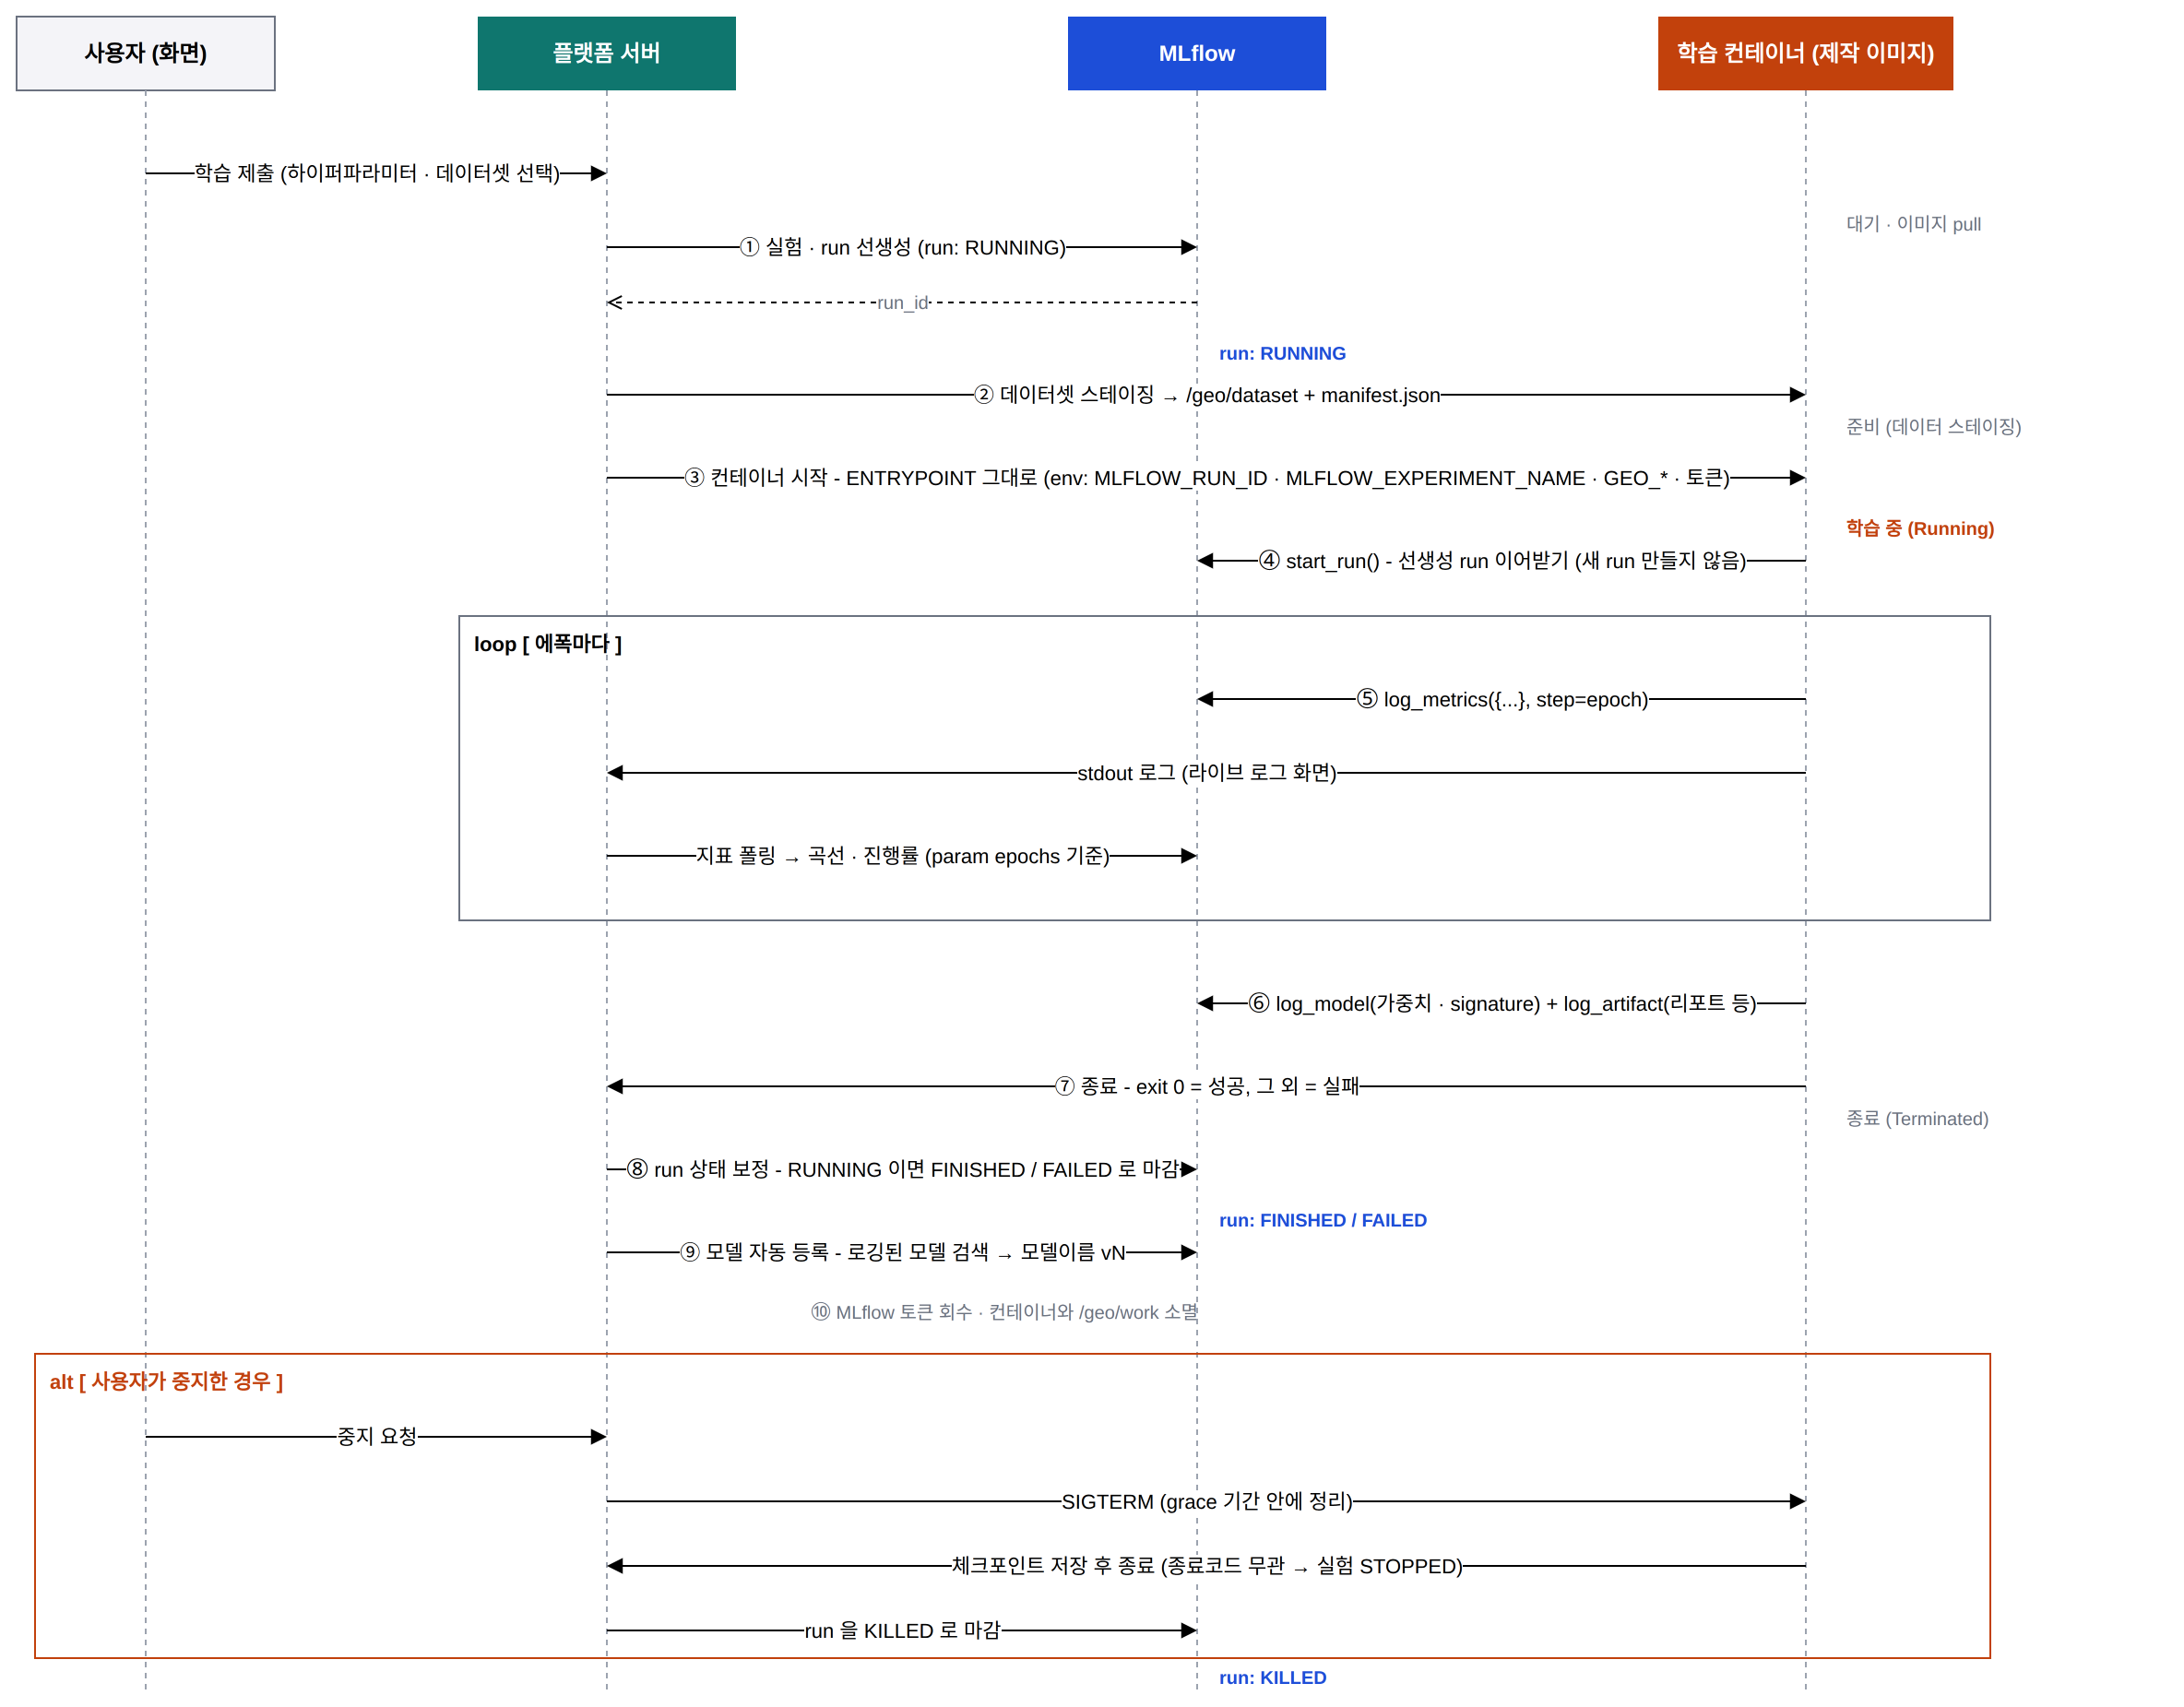
- MLflow run 은 제출 시점에 이미 만들어져 있습니다(①). 컨테이너의
mlflow.start_run()은 그 run 을 이어받을 뿐입니다(④). 컨테이너가 run 을 닫지 못하고 죽어도 최종 상태는 플랫폼이 종료 코드를 보고 마감합니다(⑧). - 로그와 지표는 길이 다릅니다. 표준 출력은 화면의 라이브 로그로만 흐르고, 곡선과 진행률은 플랫폼이 MLflow 에서 읽습니다(⑤).
print로 찍은 숫자는 곡선이 되지 않습니다. - 데이터 준비는 학습 코드가 시작되기 전에 끝납니다(②). 파드의 init 컨테이너가 데이터셋을 받아
/geo/dataset에 놓고, 그다음에 여러분의 이미지가 뜹니다.
서버가 보여 주는 6단계
학습 상세 화면의 진행 단계 는 6단계로 고정돼 있고, 모두 플랫폼이 관측한 사실로만 움직입니다. 트레이너가 단계를 알릴 방법은 없고, 알릴 필요도 없습니다.
| # | 스텝 키 | 화면 이름 | 무엇을 보고 넘어가나 |
|---|---|---|---|
| 1 | queue | 실행 대기 | 제출부터 실행 슬롯이 날 때까지 |
| 2 | runtime_prepare | 학습 환경 준비 | 학습 런타임 변형 해석, 이미지 pull 자격 증명 준비 |
| 3 | data_stage | 데이터셋 준비 | init 컨테이너의 데이터셋 스테이징(파일 수 기준 진행률) |
| 4 | train | 학습 | 여러분의 ENTRYPOINT. 진행률 = MLflow 의 max(step)+1 / params.epochs |
| 5 | register | 모델 레지스트리 등록 | 로깅된 모델을 레지스트리에 새 버전으로 등록 |
| 6 | finalize | 결과 정리 | 상태 마감, 실행용 토큰 회수 |
이 절의 순서
- 트레이너가 할 일 3가지: 지표, 모델 로깅, 종료 코드
- 컨테이너 안 경로와 환경 변수
- MNIST 예제 전체: 복사해서 학습 코드만 바꾸면 되는 한 벌
- 로컬에서 먼저 검증하기
- 플랫폼에 이미지 올리기: tar 반입 또는
docker push - 마법사에서 고르게 하기: 외부 이미지 변형
- 카탈로그 등록 요청: 새 태스크·모델·하이퍼파라미터
- 내장 학습 런타임: YOLO · RF-DETR · Pointcept
- 사전학습 가중치
- 자주 나는 실패